TLDR
- Chatbots auf Basis von Sprachmodellen formulieren dieselbe Antwort jedes Mal anders. Ein Test, der Texte Zeichen für Zeichen vergleicht, meldet deshalb Fehler, wo keine sind.
- Der Ausweg: Du prüfst Aussagen statt Wortlaut und lässt das ganze Gespräch führen, nicht nur eine einzelne Frage beantworten.
- Im Hands-On setzen wir das mit gentesty um, unserem eigenen Produkt: Bot anlegen, Testfall schreiben, Run starten, Ergebnis lesen.
- Voicebots testet gentesty per Telefonanruf. Dafür reicht die Telefonnummer des Bots.
- Über die API starten dieselben Testfälle aus einer CI-Pipeline und werden so zu Regressionstests.
Einleitung
Heute geht es um eine Frage, die sich jedem Team stellt, das einen Chatbot auf Basis eines Sprachmodells betreibt: Wie testet man einen Bot, der auf dieselbe Frage nie zweimal gleich antwortet?
Bei klassischer Software ist die Sache klar. Eingabe rein, erwartete Ausgabe raus, und wenn beides nicht zusammenpasst, ist der Test rot. Ein Bot mit einem Sprachmodell dahinter hält sich nicht an diese Abmachung. Er antwortet einmal mit „Ihr Termin ist bestätigt“ und beim nächsten Mal mit „Alles klar, der Termin steht“. Beide Antworten sind richtig, ein Textvergleich meldet trotzdem einen Fehler.
Eine Sache nehme ich direkt vorweg: gentesty, das Werkzeug aus dem Hands-On, ist unser eigenes Produkt. Wir haben es bei b-nova gebaut, weil wir genau dieses Problem lösen wollten. Dieser TechUp ist also kein neutraler Werkzeugvergleich. Der Hintergrund-Teil gilt aber unabhängig davon, womit du am Ende testest.
Hintergrund
Warum exakte Vergleiche scheitern
Wer einen LLM-basierten Bot mit festen Textvergleichen testet, landet meist in einer von zwei Sackgassen. Entweder schlagen die Tests ständig fehl, obwohl der Bot inhaltlich richtig antwortet, und werden irgendwann ignoriert. Oder die Erwartungen werden so locker formuliert, dass sie nichts mehr prüfen.
Dazu kommt, dass sich das Verhalten eines solchen Bots an Stellen ändert, die im Code gar nicht auffallen: ein angepasster Prompt, ein neues Sprachmodell, eine geänderte Wissensbasis. Jede dieser Änderungen kann eine Antwort verschieben, die gestern noch gepasst hat.
Aussagen prüfen statt Wortlaut
Die Lösung ist, eine Ebene höher zu prüfen. Statt eines festen Satzes erwartest du eine Aussage:
| Statt | Besser |
|---|---|
| „Ihr Termin am 3. Mai um 10 Uhr ist bestätigt.“ | Der Bot bestätigt den Termin am 3. Mai um 10 Uhr. |
| „Bitte nennen Sie Ihre Kundennummer.“ | Der Bot fragt nach der Kundennummer. |
| „Dazu kann ich leider keine Auskunft geben.“ | Der Bot lehnt die Rechtsauskunft ab und nennt den Kontakt. |
Ein Sprachmodell liest danach das Gespräch und entscheidet für jede Aussage, ob sie gefallen ist oder nicht. Wichtig ist, dass es dazu eine Begründung liefert. Ohne Begründung weißt du bei einem roten Test nicht, ob der Bot falsch geantwortet hat oder deine Aussage unglücklich formuliert war.
Vier Regeln haben sich für solche Aussagen bewährt:
- Konkret. „Der Bot nennt die Rückgabefrist von 30 Tagen“ lässt sich prüfen, „Der Bot ist hilfreich“ nicht.
- Eine Aussage pro Zeile. So zeigt das Ergebnis genau, was gefehlt hat.
- Das Ergebnis, nicht den Weg. Wie viele Rückfragen der Bot stellt, ist meist egal. Entscheidend ist, was am Ende feststeht.
- Auch Verbote. „Der Bot nennt keinen Preis“ ist eine prüfbare Aussage.
Das ganze Gespräch, nicht eine Antwort
Ein einzelnes Frage-Antwort-Paar sagt wenig über einen Bot, der ein Anliegen über mehrere Schritte bearbeitet. Fehler entstehen oft erst im Verlauf: Der Bot vergisst eine Angabe vom Anfang, fragt doppelt nach oder bricht nach einer Korrektur ab.
Ein Test muss das Gespräch deshalb von Anfang bis Ende führen. Und weil der Bot frei antwortet, muss auch die Gegenseite reagieren können. Ein festes Skript passt nach der ersten unerwarteten Rückfrage nicht mehr. Die Rolle des Nutzers übernimmt also ebenfalls ein Sprachmodell, das weiß, wer es ist und was es will.
Damit stehen die drei Anforderungen an ein Testwerkzeug fest: Es führt das Gespräch selbst, es bewertet nach Bedeutung und begründet sein Urteil, und es lässt sich beliebig oft mit denselben Testfällen wiederholen.
Hands-On
Die Bausteine
Ein Test in gentesty besteht aus vier Teilen:
| Begriff | Bedeutung |
|---|---|
| Chatbot | Der Bot, den du testest, mit der Adresse der Webseite, auf der er läuft. |
| Testfall | Ein Gespräch, das gentesty als Nutzer mit deinem Bot führt, und die Antworten, die du dabei erwartest. |
| Evaluator | Vergleicht nach dem Gespräch die Nachrichten deines Bots mit den erwarteten Antworten. |
| Run | Eine Ausführung eines Testfalls: das Gespräch und seine Bewertung. |
Zum Ausprobieren reicht der Free-Plan mit einem Bot und 10 Testminuten pro Monat.
Schritt 1: Chatbot anlegen
Unter Chatbots legst du den Bot mit einem Namen und seiner URL an. Das ist die Adresse der Webseite, auf der dein Chatbot läuft. gentesty testet von außen, über dieselbe Oberfläche, die auch deine Nutzer sehen. Am Bot selbst musst du nichts umbauen.
Für Dialogflow, Kore.ai und Vapi gibt es vorgefertigte Integrationen. Steht deine Plattform nicht in der Liste, wählst du Meinen Chatbot verbinden. gentesty untersucht dann die Webseite und richtet die Integration selbst ein.
Eine Einschränkung solltest du kennen: Die Seite muss aus dem Internet erreichbar sein. Adressen in deinem internen Netz ruft gentesty nicht auf.
Schritt 2: Testfall schreiben
Ein Testfall legt fest, womit das Gespräch beginnt, wer der Nutzer ist, wann das Gespräch endet und was du vom Bot erwartest. Als Beispiel nehmen wir ein Anliegen, das fast jeder Support-Bot kennt:
| Feld | Wert |
|---|---|
| Testszenario-Name | Passwort zurücksetzen |
| Anfangsnachricht | Ich habe mein Passwort vergessen. |
| Abschlusskriterien | Der Bot hat erklärt, wie ich das Passwort zurücksetze. |
| Kontext | Du bist Tim Muster, Kundennummer 48213. Deine E-Mail-Adresse lautet tim@example.com. |
Die Anfangsnachricht ist die erste Nachricht an den Bot. Der Kontext beschreibt, wer der Nutzer ist und was er weiß. Damit beantwortet gentesty die Rückfragen des Bots. An den Abschlusskriterien erkennt gentesty, dass das Gespräch zu Ende ist.
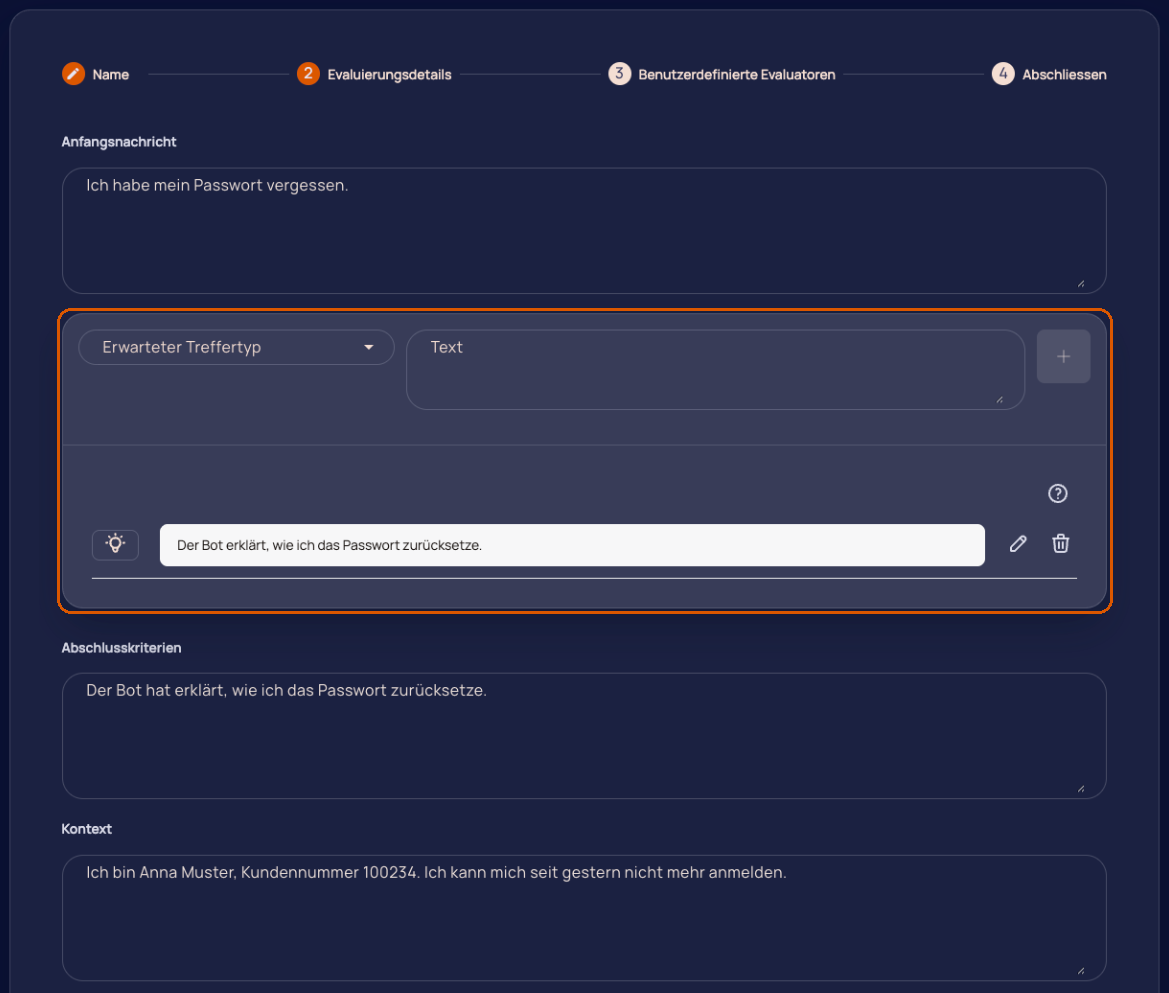
Dazu kommen die erwarteten Ergebnisse. Jedes hat einen Treffertyp:
| Treffertyp | Erfüllt, wenn eine Nachricht des Bots … |
|---|---|
| Exakte Übereinstimmung | Zeichen für Zeichen dem Text entspricht. |
| Semantische Übereinstimmung | dasselbe bedeutet, auch wenn sie anders formuliert ist. |
| Teilweise Übereinstimmung | den Text unverändert als zusammenhängendes Stück enthält. |
| Token-Übereinstimmung | alle Wörter einer vorgegebenen Zeile enthält, in beliebiger Reihenfolge. |
Für einen LLM-Bot ist die semantische Übereinstimmung der Normalfall. Die exakten Typen bleiben nützlich, wo der Wortlaut tatsächlich feststeht, etwa bei einer Telefonnummer oder einem rechtlich vorgegebenen Hinweis.
Der fünfte Typ, die Gesprächsaussage, prüft keine einzelne Nachricht, sondern das Gespräch als Ganzes. Ein Beispiel: „Der Chatbot fragt keine Angabe erneut ab, die der Nutzer bereits genannt hat.“ Dafür liest gentesty alle Nachrichten zusammen, die des Bots und die eigenen. Genau solche Fehler im Verlauf findest du mit einem einzelnen Frage-Antwort-Test nicht.
Zum Schluss wählst du mindestens einen Evaluator. Jeder neue Workspace bringt den Semantic Evaluator mit. Ohne Evaluator wird das Gespräch nicht bewertet, und der Run endet als fehlgeschlagen.
Schritt 3: Run starten
Ein Klick auf das Play-Symbol startet den Testfall. Du kannst auch mehrere Testfälle markieren oder alle Testfälle eines Bots auf einmal starten. Ein Run läuft dann so ab:
- gentesty öffnet die Webseite deines Chatbots und schickt die Anfangsnachricht.
- gentesty liest jede Antwort des Bots und antwortet als Nutzer. Was der Nutzer weiß, kommt aus dem Kontext.
- Nach jeder Antwort des Bots prüft gentesty die Abschlusskriterien. Sind sie erfüllt, endet das Gespräch und die Evaluatoren bewerten es.
Zwei Sicherungen verhindern, dass ein Gespräch endlos läuft. Die erste ist die maximale Zahl der Nachrichtenwechsel, voreingestellt sind 10. Die zweite greift, wenn der Bot mehrmals hintereinander dasselbe sagt, auch mit anderen Worten. In beiden Fällen wird das Gespräch gestoppt, bis zu diesem Punkt bewertet, und der Run gilt als fehlgeschlagen. Ein Bot, der sich im Kreis dreht, fällt so von selbst auf.
Schritt 4: Ergebnis lesen
Die Seite eines Runs zeigt pro Evaluator eine Karte mit dem Gesamtergebnis und je einem Urteil pro erwartetem Ergebnis. Ist eines nicht erfüllt, steht unter Grund die Ursache.
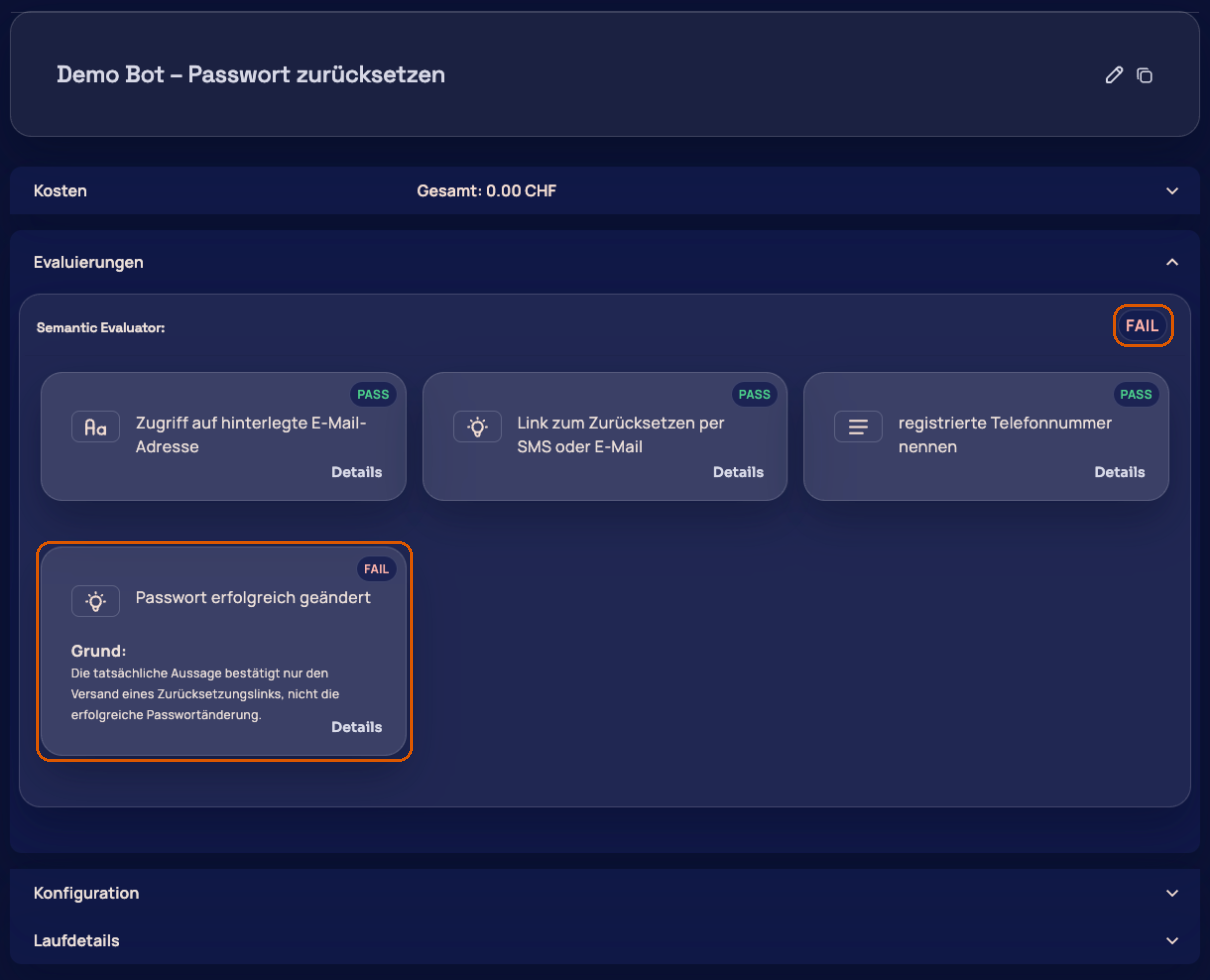
Ein einziges nicht erfülltes Ergebnis genügt, damit der Evaluator den Run als nicht bestanden meldet. Darunter findest du das vollständige Gespräch. Solange der Run läuft, erscheinen neue Nachrichten dort live.
Die Begründung ist der Teil, den ich bei jedem roten Run zuerst lese. Sie zeigt, ob der Bot wirklich etwas falsch gemacht hat oder ob die erwartete Aussage zu eng formuliert war. Im zweiten Fall ist der Testfall das Problem, nicht der Bot.
Voicebots: derselbe Test per Anruf
Bei einem Sprachbot am Telefon gehören auch die Leitung, die Spracherkennung und die Sprachausgabe zum Ergebnis. Ein realistischer Test ruft den Bot deshalb an, statt nur seine Logik mit Text zu füttern.
In gentesty hinterlegst du dafür die Telefonnummer, unter der dein Voicebot erreichbar ist. Eine technische Integration ist nicht nötig, und auf welcher Plattform der Bot gebaut ist, spielt keine Rolle. gentesty wählt die Nummer, wartet, bis der Voicebot spricht, und führt das Gespräch wie ein Anrufer. Der Testfall sieht aus wie beim Chatbot: wer ruft an, was will er, was soll am Ende herauskommen.
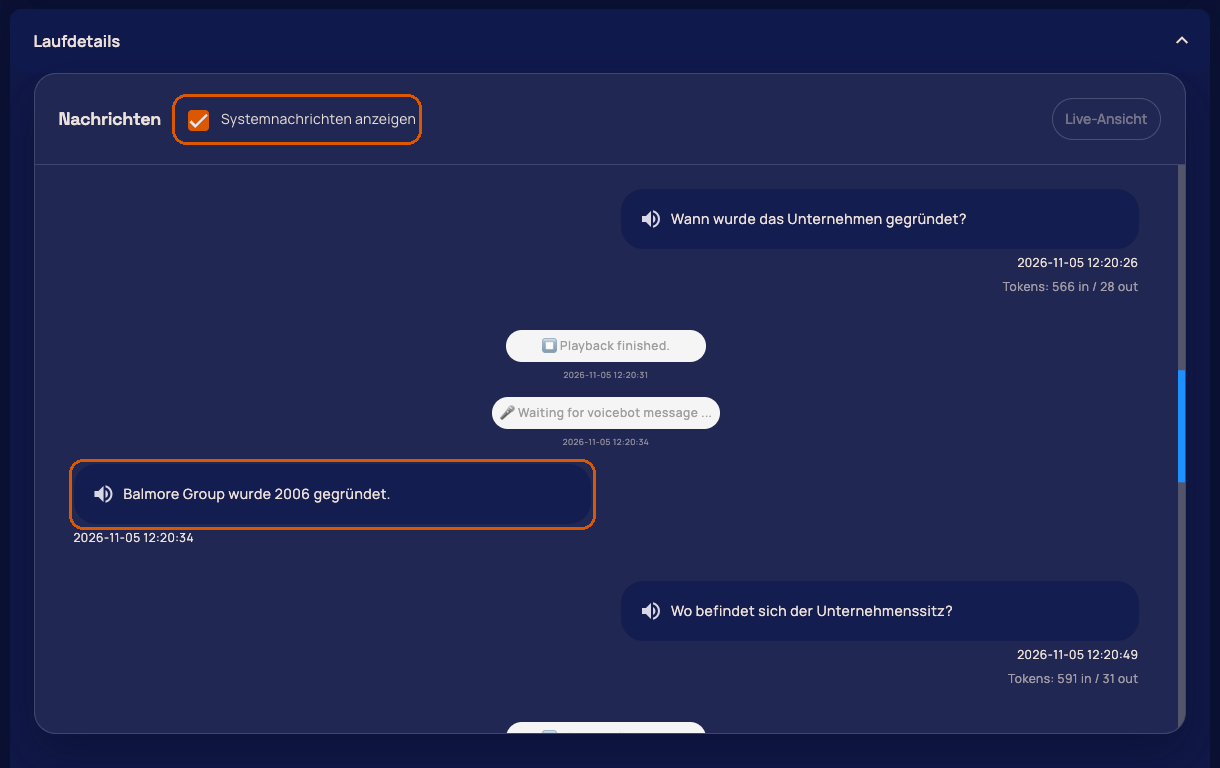
Zu jedem Run gibt es die Aufnahme des Anrufs und das Transkript. Das ist praktisch, wenn die Bewertung rot ist und du wissen willst, ob der Bot den Anrufer falsch verstanden oder falsch geantwortet hat.
Regressionstests in der Pipeline
Ein Test, den jemand von Hand startet, läuft irgendwann nicht mehr. Der eigentliche Nutzen entsteht, wenn dieselben Testfälle vor jedem Release automatisch laufen. Dafür gibt es die gentesty API v1. Sie setzt das Enterprise-Abo und einen API-Client voraus, den du im Dashboard anlegst.
Die Anmeldung läuft über den OAuth-2.0-Flow Client Credentials. Ein Token gilt 5 Minuten, deshalb holen die Hilfsfunktionen für jeden Aufruf ein frisches:
|
|
Testfälle lassen sich mit Tags gruppieren. Das Skript startet alle Testfälle eines Tags, zum Beispiel alle, die vor einem Release laufen sollen:
|
|
Danach wartet es, bis die Run-Gruppe fertig ist, und gibt die nicht bestandenen Evaluatoren pro Testfall aus:
|
|
Die letzte Zeile sorgt dafür, dass der Pipeline-Schritt fehlschlägt, wenn die Run-Gruppe nicht bestanden hat. Statt tag_ids gehen auch bot_ids für alle Testfälle eines Bots und case_ids für einzelne Testfälle. Für Voicebots setzt du bot_type auf voicebot.
Wer keine Pipeline anbinden will, kann Testläufe auch planen. Fehlschläge meldet gentesty dann per E-Mail, Slack, Microsoft Teams oder Rocket.Chat, ab dem Business-Plan.
Worauf du achten solltest
Ein paar Dinge sollte man wissen, bevor man sich auf solche Tests verlässt:
- Die Bewertung stammt selbst von einem Sprachmodell. Je konkreter die erwartete Aussage, desto verlässlicher das Urteil. Vage Aussagen führen zu wackeligen Ergebnissen. Lies bei roten Runs die Begründung, bevor du am Bot etwas änderst.
- Der Test sieht nur, was ein Nutzer sieht. Das ist Absicht, heißt aber auch: Ob im Hintergrund das richtige System aufgerufen wurde, prüfst du damit nicht. Dafür brauchst du weiterhin Tests auf der Ebene darunter.
- Der Bot muss von außen erreichbar sein. Ein Chatbot, der nur im internen Netz läuft, lässt sich so nicht testen.
- Nicht alles gibt es in jedem Plan. Die API gehört zum Enterprise-Abo, eigene Evaluatoren mit eigenem Prompt gibt es ab Business. Die Details stehen auf der Seite Preise.
Fazit
Bots auf Basis von Sprachmodellen lassen sich testen, nur nicht mit den Mitteln, die wir von klassischer Software gewohnt sind. Wer Aussagen statt Wortlaut prüft und ganze Gespräche statt einzelner Antworten führen lässt, bekommt Tests, die bei einer anderen Formulierung grün bleiben und bei einem inhaltlichen Fehler rot werden.
Meine persönliche Einschätzung: Der größte Hebel liegt weniger im Werkzeug als in den Testfällen. Zehn sauber formulierte Szenarien für die wichtigsten Anliegen, die vor jedem Release laufen, bringen mehr als hundert vage. Fang mit den Gesprächen an, die im Betrieb schon einmal schiefgegangen sind.
Wenn du tiefer einsteigen willst, findest du auf gentesty.com die Seiten Chatbots automatisiert testen und Voicebots per Telefonanruf testen, den Ratgeber Regressionstests für Chatbots und Voicebots und die Anleitungen für die ersten Schritte und die API.
 Stefan Welsch
 – Manitu, Pionier, Stuntman, Mentor. Als Gründer von b-nova ist Stefan immer auf der Suche nach neuen und vielversprechenden Entwicklungsfeldern. Er ist durch und durch Pragmatiker und schreibt daher auch am liebsten Beiträge die sich möglichst nahe an 'real-world' Szenarien anlehnen.